
服务集群解决方案大整理!
保留所有版权,请引用而不是转载本文(原文地址 https://yeecode.top/blog/139/ )。
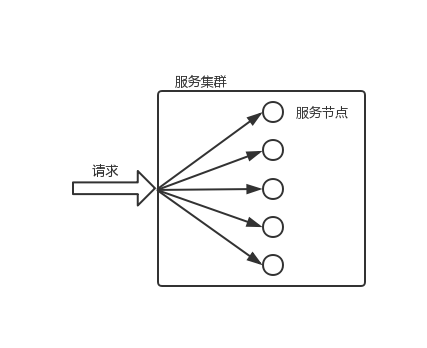
很多人一听到"集群",脑子里浮现的就是"多部署几台机器"。这话没错,但不完整。集群系统的本质,是把原本落在一个节点上的请求,通过反向代理这类手段,分摊到多个同质节点上——这些节点配置一样、跑的程序一样,一起对外提供服务。系统结构如图 1所示。
但"多部署几台"马上带来一个绕不开的问题:同一个用户先后发出的多个请求,可能落在不同的节点上,服务的连贯性就被打破了。比如用户先发 R1、再发 R2,而 R2 要靠 R1 留下的信息才能跑(R1 触发了一个任务,R2 来查这个任务的结果)。要是 R1、R2 被分到不同节点,R2 自然就查不到。
为了解决这个问题,业界沉淀出了几种典型的集群方案,我们挨个看。
无状态的节点集群
最容易从单节点扩展到多节点的,是无状态系统。所谓无状态节点,是说用户先后发 R1、R2 两个请求,不管它们是不是落到同一个节点,R2 拿到的都应该是一样的结果——节点给出什么答复,和它之前有没有收到过 R1 完全无关。
要让系统满足无状态,前提是它所有的接口都是"幂等类"接口,也就是调用前后系统状态不发生任何改变。显然,只有查询类接口才能做到这一点。
不过,就算是一堆无状态节点凑成的系统,也会遇到协作问题,最典型的就是"并行唤醒"。比如我们要给这个无状态集群加个定时功能:每天凌晨对外发一封邮件。结果你会发现,集群里每个节点都会在凌晨被同时唤醒,然后各自发一封邮件——因为所有节点同质、跑的程序一致。
解决办法是用"外部请求唤醒":在指定时刻由外部系统发一个请求来触发定时任务。这个请求最终只会交给一个节点处理,于是就实现了"只发一封"的独立唤醒。
无状态节点集群设计简单、扩展方便,但只适合本身就能满足无状态要求的系统,应用范围比较受限。
单一服务节点集群
很多服务是有状态的:用户的历史请求在系统里攒成了上下文,系统必须结合上下文来回应。比如聊天系统里用户之前的对话、游戏里用户之前买的装备和等级,都是上下文。
单一节点的系统里,把每个用户的信息都存这一台上就行;到了集群里就麻烦了。最简单的一招,是在"用户"和"节点"之间建立对应关系:
- 任意用户都对应一个固定节点,这个节点上存着该用户的上下文;
- 用户的请求永远落到与之对应的节点上。
图 2展示了这种对应关系。
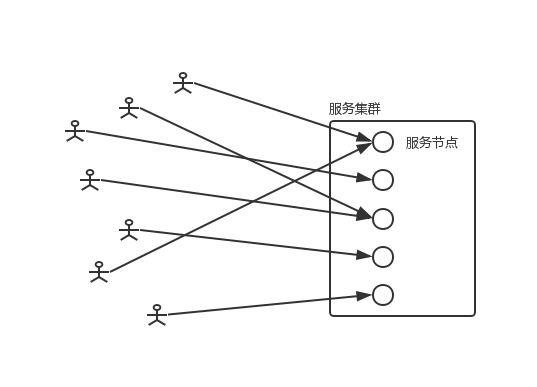
这种系统的特点是各个节点相互隔离:同样的代码、同样的配置,却各自守着不同用户的上下文,服务自己对应的那批用户。对用户来说,服务他的始终就是那一个节点,所以我们叫它"单一服务节点集群"。
建立和维护这种对应关系,常见的做法有几种:
- 注册时让用户自己选节点(很多游戏服务这么干);
- 注册时按用户所处网络分配节点(部分邮件服务这么干);
- 注册时按用户 id 分配节点(不少聊天系统这么干);
- 登录时随机或按规则分配节点,把结果写进 cookie,之后按 cookie 把请求路由到指定节点。
最后一种和前面几种略有不同:前面几种能保证"用户→节点"的绑定在整个用户生命周期内不变,最后一种只保证在一次会话周期内不变,适合两次会话之间本就没有上下文关系的场景,比如登录系统、权限系统。
无论哪种方式,都保证了会话过程中用户对应的节点不变,系统只要在会话里把请求路由过去即可,路由由反向代理、规则中心等组件完成。
单一服务节点集群能解决有状态服务的问题,但因为节点彼此隔离、无法互相备份,一旦某个节点崩溃,它名下的用户就失去了服务——容错性比较差。
信息共享的节点集群
有没有既能解决有状态问题,又不会因单点崩溃而让用户失服的方案?有,就是信息共享的节点集群。在这种集群里,所有节点连到一个公共的信息池,用户的上下文信息都存在这个池子里。系统结构如图 3所示。
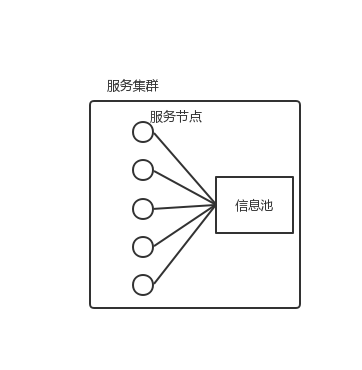
这是把单节点系统扩成多节点系统最常用的一招。通常服务节点和信息池分开部署在不同机器上,加节点就能扩集群。
数据库就常当作信息池用:任意节点收到请求,都从库里读该用户的上下文,处理完再把新状态写回库。除了传统数据库,也可以是别的信息池——比如用 Redis 把信息池当共享内存,存用户的 Session 信息。
在信息共享的集群里,每个节点都从信息池读写用户状态,所以对用户而言每个节点都是等价的,请求落谁都一样。
节点间信息互通,就能用分布式锁解决"并行唤醒"这类协作问题。一个简单的做法是:定时任务触发时,每个节点都以同一个键往信息池里写一个"不允许覆盖"的数据,最终只有一个节点能写成功,它拿到执行权。
信息共享的节点集群靠加节点提升了运算能力,但因为多个节点共享同一个信息池,受信息池容量和读写性能制约,系统在存储容量、数据吞吐上的提升并不明显。
信息一致的节点集群
信息共享的集群,运算能力分散在各个节点,存储能力却集中在信息池——信息池成了故障单点和性能瓶颈。
要避免这个瓶颈,可以让每个节点各自拥有一个信息池。但为了保持有状态服务,又必须保证各个信息池里的数据是一致的,如图 4所示。
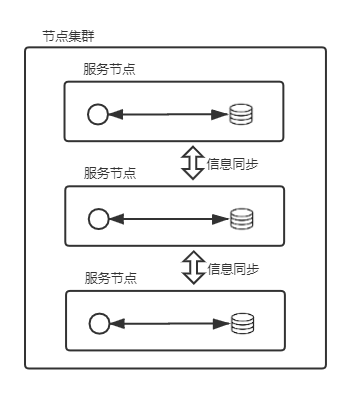
这种"信息一致的节点集群"常被叫作分布式系统,但严格说它仍是集群——因为分布式系统的节点是异构的,分属不同模块;而这里的节点是同构的,出现的目的只是为了分担高并发带来的压力。不过,它也得面对分布式系统常遇到的那个老问题:分布式一致性。
一致性要求:在系统的某个节点上做了变更,经过"一定时间"后,能从每个节点上读到这个变更。
我们用图 5的例子直观看看一致性问题。
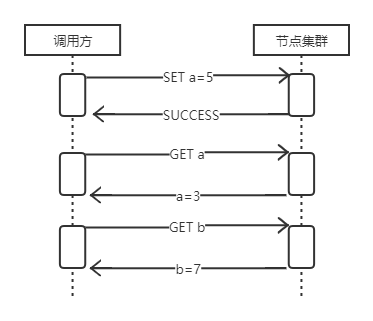
图里调用方先通过节点集群把变量 a 设成 5,再去读 a,结果读到的却是 3。这完全可能发生,因为两次读写可能访问的是两个节点,只要节点间信息不同步、或同步有时延,就会出现。
如果这种情况可能发生,那这个节点集群就不满足一致性(至少不满足线性一致性)。不满足一致性的话,从集群里读出的任何值都不可信——比如某调用方读出 b=7,这个结论不可信,因为同一时刻别的调用方完全可能读到 b=8。
定义一致性时我们说"一定时间后"能读到变更。按"一定时间"的长短,一致性分成很多类型:严格一致性、线性一致性(又叫强一致性、原子一致性)、因果一致性、最终一致性,等等。
要实现分布式一致性,核心就是完成节点间的信息同步。要同步到什么强度,成本就不一样:要实现线性一致性,可以用两阶段提交、三阶段提交等算法,但这些会对各节点的吞吐量造成较大影响;要实现最终一致性,可以用带重试的异步消息中心等,对吞吐量影响小,但集群可能出现读写不一致。具体用哪种同步达到哪种级别,得看实际场景定夺。
信息一致的节点集群适合读多写少的场景:这种场景下节点间同步少,又能充分发挥多个信息池的吞吐优势。
在 AI 编程能帮我们快速产出代码的今天,把系统从单节点扩展到多节点、让服务稳稳扛住高并发,靠的依然是扎实的架构功底。聊完服务集群的几种方案,如果你觉得架构、性能这些话题有意思,强烈推荐一本书《高性能架构之道(第二版)》。
这是一本理论联系实际的架构书,系统讲了怎么从顶层把软件架构好:覆盖分布式、并发编程、数据库调优、缓存、IO、高可用、前端性能优化等众多知识,最后还拿一个真实项目完整走了一遍架构全过程,把书里的方法真正落了地。
这本书还在台湾地区出了繁体版,叫《巨型服务架构》——繁体版嘛,贵得有点离谱。
就先聊到这儿。
我是软件架构师易哥。可以关注我,我会偶尔冒个泡,分享点编程干货!
可以访问个人知乎阅读更多文章:易哥(https://www.zhihu.com/people/yeecode),欢迎关注。
作者书籍推荐

