
什么是分布式系统?
保留所有版权,请引用而不是转载本文(原文地址 https://yeecode.top/blog/140/ )。
集群系统把单节点的并发请求分散到多个节点上,降低了每个节点的压力。它有个前提:各个节点是同质的,各跑一套完整且相同的应用。
但应用是会长大的。功能越加越多、边界越扩越宽,最后往往长成一个包含众多模块的单体应用(也叫巨石应用)。这种应用跑在物理节点上,CPU、内存、IO 等资源一吃紧,性能就往下掉——而且这跟并发高不高无关,纯粹是系统自身太复杂了。
除了效率,单体应用还带来开发、维护、可靠性上的一堆麻烦:
- 业务复杂:模块多,彼此还耦合。新开发者上手就得先搞懂所有模块的业务逻辑;
- 变更维护复杂:任何一点微小的升级,都要重新部署整个系统,外加一堆全量测试、回归测试;
- 难以分拆升级:不同组件需要的资源不一样,但都被绑在一起,没法单独升级;
- 可靠性变差:任何一个模块异常都可能拖垮整个应用,而模块众多又让恢复变得很慢。
把这些问题的解法,就是把单体应用拆成多个子应用,让每个子应用单独部署到一台机器上。这一拆,单体应用就变成了分布式应用,如图 1所示。
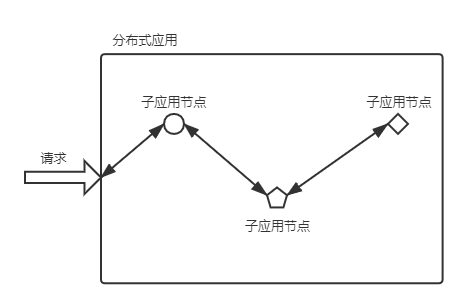
分布式应用通过拆分子应用,把原本集中在一台机器上的压力分散到多台机器上,进一步提升了承载能力;同时让内部模块之间解耦,子应用可以独立地开发、部署、升级、维护。
当然,分布式应用也要面对分布式一致性问题。比如一个分布式系统里,子应用 A1 管订单、A2 管库存,外部购买请求到达后,如果 A1 完成了订单生成,A2 就得完成库存扣减——两个子应用的状态变化也得是一致的。具体怎么实现,和我们在"信息一致的节点集群"里介绍的方法一样,这里不再赘述。
实际生产里,建议优先把大的单体应用拆成分布式系统;等拆出来的某个子应用因为并发过高又遇到瓶颈时,再把它按需部署成集群,如图 2所示。
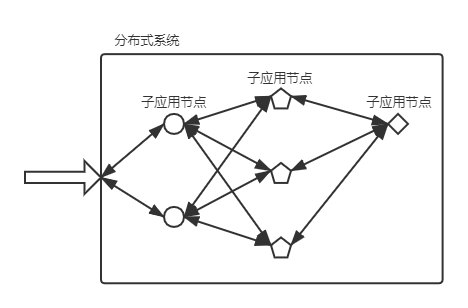
这种"先拆分布式、再按需上集群"的演进方式,让每个子应用能针对自身的制约因素去扩展——有的要扩计算、有的要扩存储、有的暂时不用扩,避免了直接扩展大单体造成的资源浪费,更合理、也更高效。
在 AI 编程越来越能替我们写完业务代码的今天,怎么把一个庞杂的系统拆分、部署、扩展得既稳又省,反而成了更值钱的能力。聊完分布式系统的来龙去脉,如果你觉得架构这些话题有意思,强烈推荐一本书《高性能架构之道(第二版)》。
这是一本理论联系实际的架构书,系统讲了怎么从顶层把软件架构好:覆盖分布式、并发编程、数据库调优、缓存、IO、高可用、前端性能优化等众多知识,最后还拿一个真实项目完整走了一遍架构全过程,把书里的方法真正落了地。
这本书还在台湾地区出了繁体版,叫《巨型服务架构》——繁体版嘛,贵得有点离谱。
就先聊到这儿。
我是软件架构师易哥。可以关注我,我会偶尔冒个泡,分享点编程干货!
可以访问个人知乎阅读更多文章:易哥(https://www.zhihu.com/people/yeecode),欢迎关注。
作者书籍推荐

