
并行计算的范式及其工程实现
保留所有版权,请引用而不是转载本文(原文地址 https://yeecode.top/blog/74/ )。
本文将会介绍并行计算的基本概念和实现形式的演化,并引出MapReduce范式和DAG范式。这些知识将帮助大家理清楚并行计算的来龙去脉和两种范式之间的关系。
本文也会详细介绍MapReduce范式和DAG范式的形式化定义,以及它们的工程实现。这些知识将帮助大家理清设计并行计算系统时面对的问题以及解决思路,将帮助大家设计实现一套并行计算系统。
本文还会介绍Hadoop和Spark的使用。Hadoop和Spark分别是MapReduce范式和DAG范式的典型工程实现。这些知识将帮助大家了解这两个系统的核心实现,并可以上手它们。
要注意的是,本文是从架构层面讨论如何设计和实现并行计算系统,而不是专门介绍Hadoop和Spark。因此在很多地方思路更为开阔,而不是全然依照这两种典型实现来阐述。本文最后也会提及,我们遵循DAG范式实现了一套与Spark截然不同的系统,服务于特定的业务场景。
本文约有1.5万字,阅读约需要20分钟。全文目录如下。
[TOC]
1 并行计算概述
并行计算是指在多个计算引擎中开展的计算,这些计算引擎共同协作完成某一项任务。
多个计算引擎可以分布在一个工作机内,例如一台多处理器工作机。多个计算引擎也可以分布在不同的工作机内,例如一个分布式系统。在本文的讨论中,我们统一用计算引擎或者节点来称呼它们,而不去细究它的物理实现。
并行计算的实施是一个复杂的问题。并行计算系统要处理以下典型问题1:
- 计算分区问题:计算分区就是要将一个计算任务拆分为可以并行开展的小任务,并将这些小任务交给不同的节点处理,然后再将小任务的结果进行汇总。这是并行计算的核心问题。
- 数据分区问题:在进行并行计算过程中,往往也需要将输入数据、中间数据、输出数据进行分区,以便于实现大文件的存取和提升数据的读取效率。
- 数据交换问题:并行计算的过程中可能会出现数据的交换需求,例如某个计算节点的数据需要交给另外的节点进一步处理。并行计算系统需要为数据交换提供可靠的支持。并且由于并行计算的任务涉及的数据量比较大,因此需要数据交换具有较高的吞吐。
- 节点调度问题:节点在运行过程中,可能因为宕机等原因退出,也可能因为数据依赖等原因等待。并行计算系统需要依据节点的工作状况、任务的进度等对参与并行计算的节点进行合理调度。整个过程中可能会涉及通信、同步等问题。
本文更关心的是计算分区问题。计算分区问题较为复杂,包含可计算性、计算复杂性、系统可靠性、网络等众多领域的知识。如果把这些问题都交给并行计算系统的开发者来解决,势必会花费其大量精力进而导致业务问题被忽视2。因此,产生了并行计算的范式。
接下来我们会介绍并行计算形式的演进,并引出其中两种极具参考性的形式:MapReduce范式和DAG范式。这两种范式的内部组件的耦合都是松散的,这使得它们的扩展能力和容错性都优于传统的并行计算模型(主要是指MPI)3。
2 并行计算的形式及范式
范式是成熟可靠的形式。并行计算的范式为并行计算系统的实施提供了标准的参考,只要按照范式提供的方案实施,开发者便可以实现一套较为成熟的并行计算系统。
并行计算范式带来了以下的优点4:
- 为并行计算问题提供了抽象和分层,屏蔽了底层资源。
- 降低了并行计算问题的理论复杂度,便于程序员进场开发。
- 提升了并行计算系统间的通用性,便于进行跨系统的交流。
目前典型的并行计算范式有MapReduce5和DAG6,对应的成熟产品有Hadoop和Spark。
很多读者都通过Hadoop和Spark对MapReduce和DAG这两种并行计算范式有一定的了解,但往往也会存在不少疑惑,这些疑惑可能包括:为什么会产生MapReduce这种形式?MapReduce能解决什么问题?MapReduce形式为什么会演化出DAG形式?两者到底有什么关系?等等。
因此在详细介绍MapReduce和DAG之前,我们先介绍并行计算框架的发展思路,以便于大家理清楚这两种范式所处的位置,以及它们之间的关系。
2.1 最简单的并行计算形式
说起并行计算,我们首先想到的最简单形式应该如下所示:
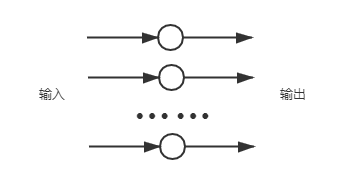
但是这并不能称之为一个真正的并行计算,因为各个计算节点都在独立进行自身的任务,而不是共同完成一项任务。计算结束后我们将得到多个结果而不是一个汇总的结果。
2.2 MapReduce形式
显然,我们可以对上述形式进行完善,对各个节点的计算结果进行汇总,如下所示:
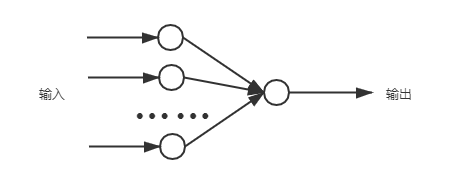
这样,计算任务被分为了两类:前面的各个节点负责进行并行的计算;后面的一个节点负责对前面并行计算的结果进行汇总。这就是MapReduce范式的形式。我们将前面并行计算节点进行的操作称为Map操作,将后面汇总节点进行的操作称为Reduce操作。
MapReduce范式的形式虽然简单,但是已经能够解决大量的并行计算问题。例如,过滤统计、搜索、排序等操作。
2.3 MapReduce级联形式
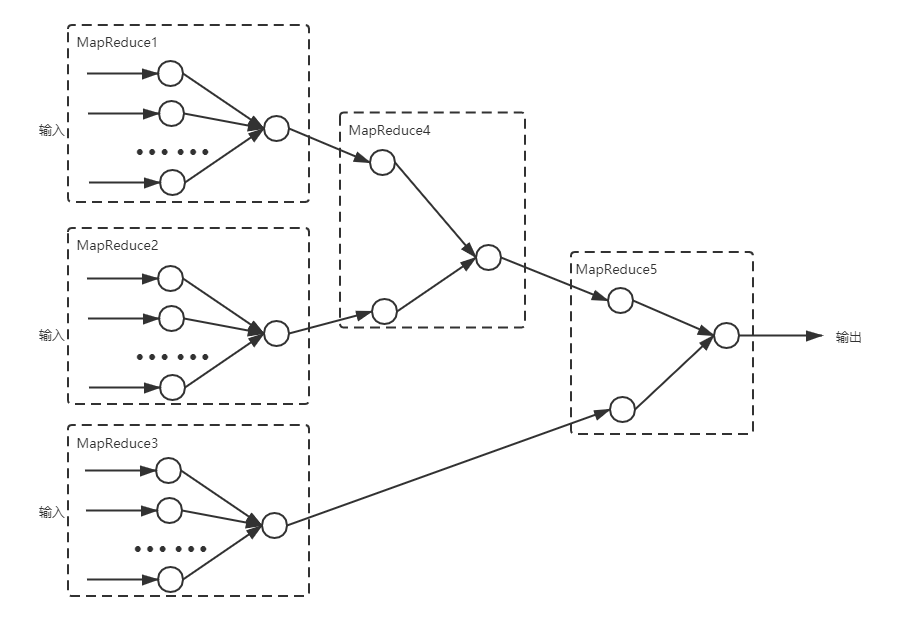
当然,仍然有一些问题没法通过单一的MapReduce解决。这时,我们想到通过多级MapReduce级联来解决更复杂的问题。
例如,下面就展示了5个MapReduce的级联。
2.4 DAG形式
这时我们依旧看着上图,思考一个问题。在MapReduce中,Map用来进行并行计算,Reduce用来进行汇总,两者共同完成一个任务。但在上图中,当多个MapReduce串联在一起时,并不是每个Map、Reduce都还有存在的意义。例如在极端情况下,Reduce操作可能只需要最后一个就可以了,而同样,很多Map操作也可以省略。这里所说的省略是指相关节点没有对数据流进行任何的修改,节点的输出数据和输入数据完全相同,即只进行了数据的透传。
如果我们用虚线圆圈表示仅做透传操作的节点,则可能会得到下面的结果:
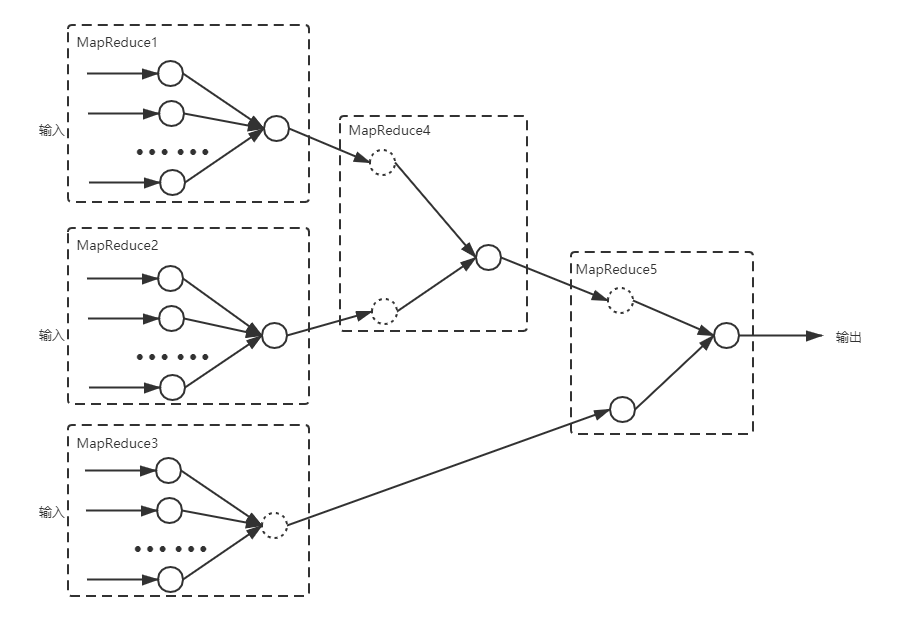
显然,这些虚线圆圈表示的节点我们可以直接忽略掉,转化为下面的形式:
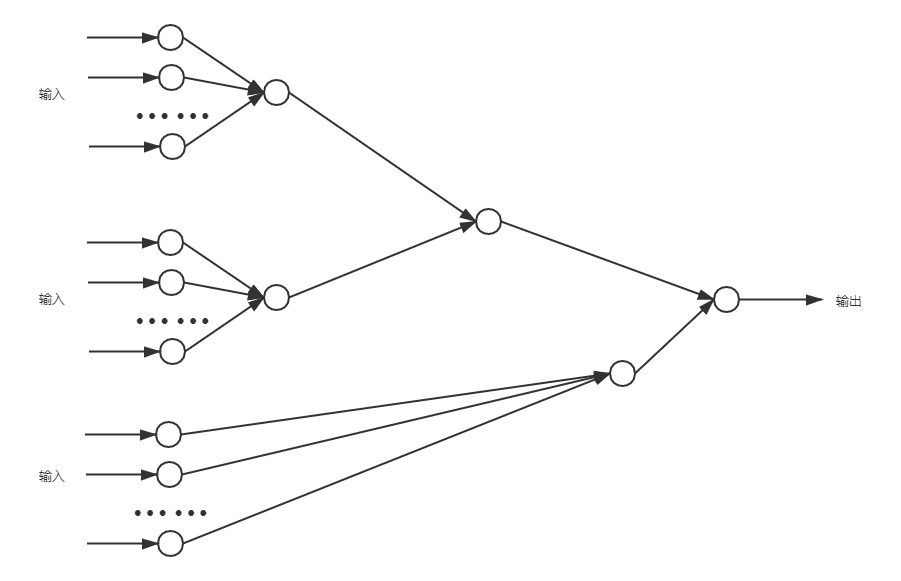
这时,Map和Reduce不再成对存在,因此也不再是MapReduce级联的形式,成了一种新的形式。
我们可以看出,这是一棵树。
既然已经到了树,我们完全可以尝试让节点连接多个父亲,进而将其泛化为图,如下所示。
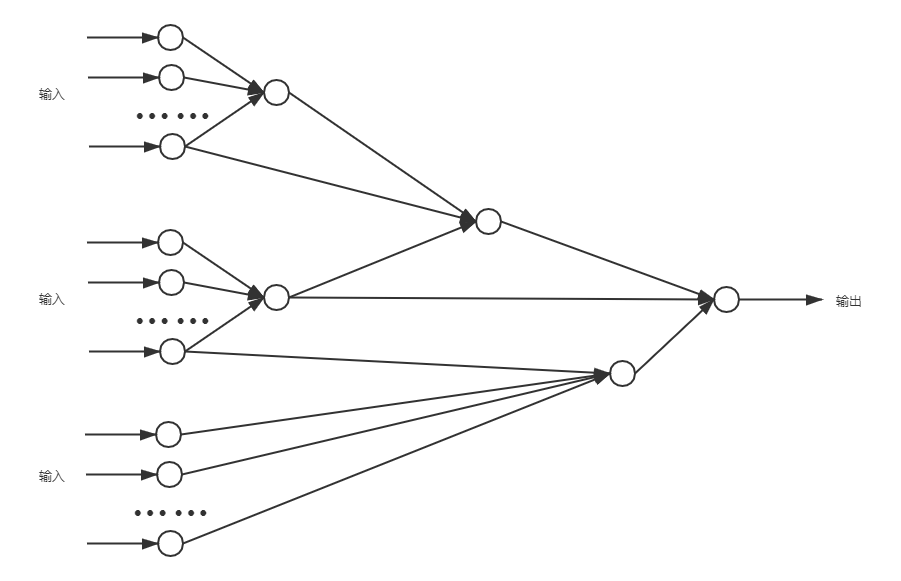
我们发现,一个节点的输出导出给多个节点、导出给非上一级节点等,都是可行的。也就是说,将树的形式升级为图的形式也是可以的,不会增加额外的复杂性。其实也可以在MapReduce级联阶段完成从树到图的升级,都是一样的。
但是这个图是有条件的。首先边是有方向的,边代表了数据流,边的方向代表了数据传输的方向。其次不能存在环,否则任务将是无法终止的。到这里,我们得到了并行计算的又一种范式:有向无环图,即DAG。
现在,我们已经讨论了并行计算的形式演进,并引出了MapReduce和DAG这两种典型的并行计算范式。在接下来的章节中,我们会对这两种范式进行更为深入的介绍。
在前面的介绍中,我们刻意避免了对包含循环调用的MapReduce展开讨论,这有利于简化讨论过程,但并不影响最终结论。
循环调用是指某个MapReduce的输出结果作为输入再次输入到前面的MapReduce中,按照这样的形式,推导出的图是有向有环的。但是,只要任务是可终止的,则说明循环次数是有限的。这种情况下,我们可以将有向有环图等价转化为一个有向无环图,其转化过程和等价性证明可以规约为非确定型有穷自动机转确定型有穷自动机的过程。
因此,通常我们使用有向无环图而不是有向有环图来描述一个并行计算任务,这不会缩小并行计算系统的应用范围,却能够极大地简化系统的设计和开发难度。
3 MapReduce范式
在本节,我们将介绍MapReduce范式的形式化表示,并介绍它的具体工程实现。
3.1 形式化表示
MapReduce范式十分简单,它将并行计算划分为并行计算的Map操作和汇总的Reduce操作,Map操作先于Reduce操作开展。
某些资料会把这里的“Map”翻译为“映射”7,将“Reduce”翻译为“化简”8,从“信、达、雅”的角度看还是十分特切的。但作者认为,用“并行计算”和“汇总”来称呼这两类操作可能更有助于让读者明白两类操作的具体内容,因此在本文中我们沿用后者。
我们可以用下面的伪代码对MapReduce范式进行形式化的表示:
output Map(input) {
	// 用来被用户重写
}

output Reduce(input) {
	// 用来被用户重写
}

output Main(List<input>) { // 输入数据是多个数据片input组成的集合List<input>
	mapsOutput; // 所有的Map的输出的集合
	for(Map in Maps){
		mapsOutput += Map(input);
	}
	return Reduce(mapsOutput);
}
上述伪代码中,用户需要定义的就是Map操作和Reduce操作。
3.2 工程实现
3.2.1 基本实现
我们可以根据MapReduce范式实现一个并行计算系统。该系统的形式是完全固化的,只预留Map操作和Reduce操作供用户定义。
Reduce操作作为汇总操作,需要有汇总的依据。因此,我们规定Map操作给出的结果为键值对形式,其中的key作为Reduce进行汇总的依据5,value作为业务信息。所以说,Map操作是一个由输入数据data生成(key,value)列表的过程。
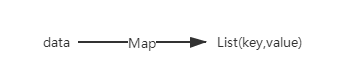
Reduce操作则以key为依据对结果进行汇总,得到最终的输出结果。
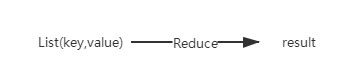
整个并行计算系统的实现中,调度工作并不复杂。包括为输入数据分配对应的Map节点,收集Map节点的输出,将Map节点的输出导入给Reduce节点等几步。
3.2.2 效率优化
提升并行计算系统的效率可以从提升系统的整体协调效率和提升每个节点的计算效率入手。对于前者是并行计算系统效率提升的关键。
在并行计算系统的运行中,往往要面对大量数据。对数据的流通进行优化可以大大提升系统的运行效率。下面我们开展这方面的工作。
3.2.2.1 外部数据到Map环节
MapReduce进行的第一步是Map读入外部数据。
因为并行计算接收的数据往往是分片的,因此多个Map会从多个数据片上获取信息。这时我们就可以发现,最好为每个Map分配一个数据片,即保证Map节点的数目和数据片的数目相等,以减少下图虚线所示的数据交叉流动。
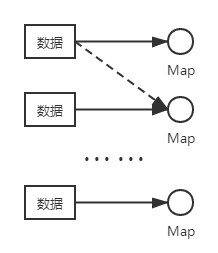
在最优情况下,数据片数目d和Map节点的数目m相等,则共有d=m个数据流。当数据片数目较多时,d>m,因为每个数据片都需要被处理,则数据流为d。当Map节点数目较多时,m>d,可以考虑让部分Map闲置,数据流仍然为d。可见,整个数据流的协调工作是简单的,即只需要为每个数据片分配一个Map节点即可。
考虑到数据片中的数据量可能不一致,则可以考虑为某个数据片分配多个Map节点。此时数据产生交叉流动,但问题也不严重,最终数据流的数目不会太大-。
3.2.2.2 Reduce环节到输出
按照数据的流转顺序,我们应该先讨论Map环节到Reduce环节,再讨论Reduce环节到输出。但在这里我们反一下顺序,因为这里的结论会对Map环节到Reduce环节产生影响。
按照标准的MapReduce范式,Map节点有多个,但是Reduce节点只有一个。但为了提升系统的并发性能,我们可以设置多个Reduce节点。让每个Reduce节点处理部分数据,即根据Map给出的(key,value)中的key进行分组,每个Reduce只处理一个或者几个key的数据。这里我们可以得出一条结论,如果Reduce节点的数目大于key的种类时,多出的Reduce节点将会被闲置,不过这种情况通常不会出现。
设置多个Reduce节点可以并发地开展Reduce操作,而不是将众多的Map结果交给单一的Reduce节点处理。我们可以根据任务中Reduce工作量的大小动态调整Reduce节点的数目,避免Reduce操作成为整个并行计算的瓶颈。另外,Reduce操作的结果需要落盘,多个Reduce节点便提供了多个独立的IO操作,将极大地提升Reduce的落盘效率。
但是多个Reduce操作会使得最终获得的结果不再是一个文件,而是多个文件的集合。每个Reduce节点都会生成一个文件,这些文件共同组成了此次MapReduce操作的结果。这通常也是可接受的。
3.2.2.3 Map环节到Reduce环节
根据前面的介绍,Map节点存在多个,假设为m个;Reduce节点也存在多个,假设为r个(假设r的数目小于等于key的种类数)。
当Map节点产生一条记录时,根据其key的不同,可能会被分配到r个Reduce节点中的任意一个。因此,系统中一共存在$m \times r$条数据通路。
然而,可怕的不是通路多,而是数据连接多。未经优化时,Map每产生一条(key,value)便对应一个到Reduce的连接,因此,整个系统中Map环节到Reduce环节需要建立的连接数目和数据的条数一致,这将是一个恐怖的数据。这会导致系统效率极低9。
显然,我们在Map中可以将发往同一个Reduce的数据集合起来,得到List(key,value)的形式,然后将List(key,value)作为一个整体以一个连接发送给指定的Reduce。这样,连接的数目降低为$m \times r$,和数据通路的数目一致。已经不能再减少了。这一步操作叫做Partition操作。
进一步地,我们还可以减少Map往Reduce发送的数据量,以便于减少通信阻塞。试想,我们已经将投递到同一个Reduce的数据集合在一起,得到了List(key,value)的形式,而且我们也知道Reduce要进行的操作是以key为依据进行汇总。那Map完全可以对它掌握的List(key,value)先进行一次汇总,得到新的List(key,value)。但是后者的列表中已经不包含重复的key值。这一步操作叫做Combine操作。Combine操作所使用的函数,实际就是Reduce操作的函数。
经过Partition和Combine操作,Map节点已经根据自身掌握的信息对数据进行了一次汇总,这降低了建立数据连接的次数也数据包的大小。后续的Reduce操作只需要在此基础上,对各个Map节点给出的结果再进行一次汇总。
Hadoop就是MapReduce范式的良好实现,而且也采取了上述的优化手段。如果阅读完这里,再上手 Hadoop将会非常简单。
3.3 典型框架Hadoop的使用
我们已经MapReduce的工程实现进行了了解,而且已经说过,这样对Hadoop上手已经非常简单了。那我们就直接上手。
题外话:Hadoop还包含了HDFS等众多组件的支持10,这些组件的设计也十分出色。但本文侧重讨论并行计算,不去涉及这些内容,感兴趣的读者可以自行研究。
假设我们存在一个如下形式的输入文本,其中记录了用户名和密码,中间用TAB隔开。现在我们要统计各个密码的出现频率,以便于指导大家设置更为复杂的密码。
xiaoming	123456
libai	123456
yee	123ABC
funny	888888
tom	abc@123
jack	123ABC
coolBoy	123ABC
lilei	123456
则根据MapReduce范式,我们需要重写的就是Map的实现函数和Reduce的实现函数。
Map的程序可以这样写,文件名为mapper.sh。
BEGIN{
    FS=OFS="\t"
}
{
    print $2,$3
}
END{}
Reduce的程序可以这样写,文件名为reducer.py。
#!/usr/bin/env python
import sys
from itertools import groupby
from operator import itemgetter

def readFromMapper(delim='\t'):
	for line in sys.stdin:
		entries= line[:-1].split(delim)
		yield entries

def aggregate():
	for (passWord,group) in groupby(readFromMapper(),itemgetter(0)):
		print passWord,":",
		count=0
		for item in group:
			count+=1
		print count

if __name__=="__main__":
	aggregate()
就这样简单,我们就完成了整个MapReduce任务的定义。实际就是给定了形式化定义中Map操作和Reduce操作。
然后就可以根据Hadoop规定的一些参数配置并启动Hadoop。
#!/usr/bin/env bash

INPUT_FILES="/input/"
OUTPUT_FILES="/output/"
MAPPER="mapper.sh"
REDUCER="reducer.py"

${HADOOP_HOME}/bin/hadoop dfs -rmr ${OUTPUT_FILES}

${HADOOP_HOME}/bin/hadoop streaming \
-D mapred.map.capacity=1000 \
-D mapred.reduce.capacity=100 \
-D mapred.map.tasks=1000 \
-D mapred.reduce.tasks=100 \
-input 	 ${INPUT_FILES} \
-output  ${OUTPUT_FILES} \
-mapper "awk -f ${MAPPER} "  \
-reducer "python	${REDUCER}" \
-file "${MAPPER}" \
-file "${REDUCER}"
上述例子中,Map操作使用了Linux命令,而Reduce使用了Python脚本。这是因为Map操作往往简单(过滤、切分等)但是面临大量的数据,而Linux命令的效率较高,适宜完成这些操作。Reduce操作往往比较复杂(关联、分析等)但经过Map的处理后面临的数据量较小,而Python存在大量便捷的库,适宜完成这些操作。当然,具体在什么环节使用什么编程语言,需要根据具体应用场景变动。
可见,在了解了其实现范式和工程实现后,再去使用系统会变得十分简单。
3.4 MapReduce的实现总结
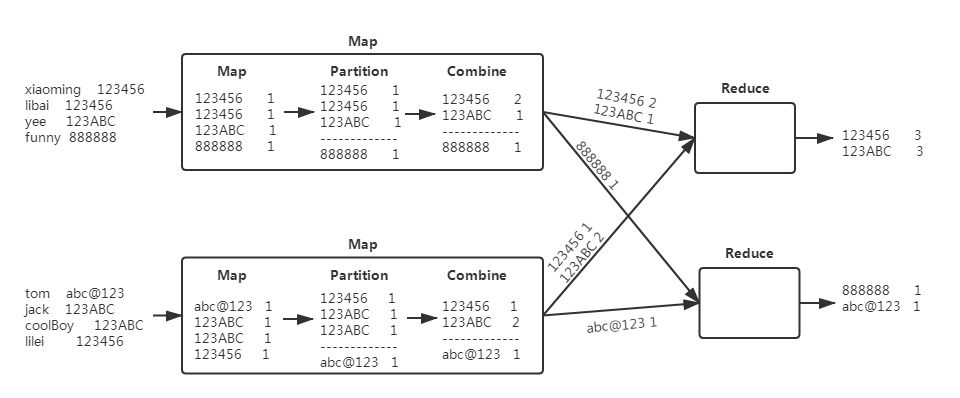
我们已经介绍了MapReduce范式的形式化表示、工程基本实现、工程优化思路,还给出了Hadoop的使用示例。经过以上过程的学习,MapReduce的具体实现过程也已经清晰。其中在Map阶段:
- 从数据片中读入数据。
- 进行Map操作,得到List(key,value)。
- 根据每条记录要发往的Reduce节点的不同 ,对List(key,value)进行分组,将发往相同Reduce节点的(key,value)集合到一起。即进行Partition操作。
- 对具有相同key值的数据进行一次汇总,使得最终List(key,value)中不包含重复的key值。即进行Combine操作。
- 将最终的List(key,value)发送给对应的Reduce。
在Reduce阶段:
- 接收各个Map节点传入的List(key,value)。
- 依据key,对具有相同key的数据进行汇总。
最终,可以得到下面的示意图。
4 DAG范式
在本节,我们将介绍DAG范式的形式化表示,并介绍它的具体工程实现。
4.1 形式化表示
DAG范式中存在两个要素:节点、有向边。节点表示了计算节点,有向边表示数据流611。其中,每个节点的具体计算函数需要开发者定义,而数据流则不需要单独定义。但是,开发者需要定义整个DAG中的点和边的关系,即提供这张图。
因此,我们可以用伪代码给出DAG范式的形式化定义。
Node{
	output Process(input) {
		// 用来被用户重写
	}
}

Graph<Node> DAG() {
	// 用户编写返回Graph<Node>的具体方法
}

output Main(input) {
	return run(Graph<Node>,input); // 把数据交给Graph<Node>处理
}
上述伪代码中,用户需要定义的就是每个节点的操作函数Process和节点组成的有向无环图Graph
4.2 工程实现
4.2.1 节点的定义
DAG范式中的节点的功能是十分自由的:
- 输入形式自由:节点接收的数据的种类、数目都不受限制。
- 输出形式自由:节点输出的数据的种类、数目也不受限制。
- 节点间无耦合:每个节点只负责自身的数据读入、计算处理、结果输出,不与其他节点产生耦合。
但是,在工程实现中,以上三者是不可能都满足的。假设节点A的输出作为节点B的输入,则节点B必须要知道节点A输出内容的形式,以便于接收后进行处理。这实际上就建立了一种耦合。这时我们面临抉择:
- 要么就牺牲输入输出形式的自由,为输入输出设立规范。确保一个节点的输出可以作为任意节点的输入。
- 要么就在节点输入中兼容其他节点的输出,即在节点间建立规则耦合。通过这种规则上的耦合,一个节点可以知道如何解析另外一个节点的输出。
相比于MapReduce的(key,value)形式的中间数据,DAG范式中节点的灵活性使得定义节点的输入输出规范是一个需要在自由和规范间不断衡量的工作。
4.2.2 DAG的确定
在用伪代码给出的形式化定义中,Graph
DAG的确定并不复杂,难的是如何让用户简单、快速、直观地确定出来。
此外,在用户确定完DAG后,系统要配套给出起点判断、终点判断、无环判断等功能,以确定用户确定出的DAG是可用的。
4.2.3 系统调度
在MapReduce范式中,整个系统的调度策略是固定的:先运行Map节点,等Map节点全部运行结束后运行Reduce节点。
在DAG范式中,系统的调度则要复杂很多。在这一节中,我们将分析DAG范式系统的系统调度问题。
4.2.3.1 节点资源调度
我们要注意到,在DAG范式下节点的任务可能在时间上是完全没有重叠的。例如下图中的节点A和节点B就在运行时间上完全没有重叠。
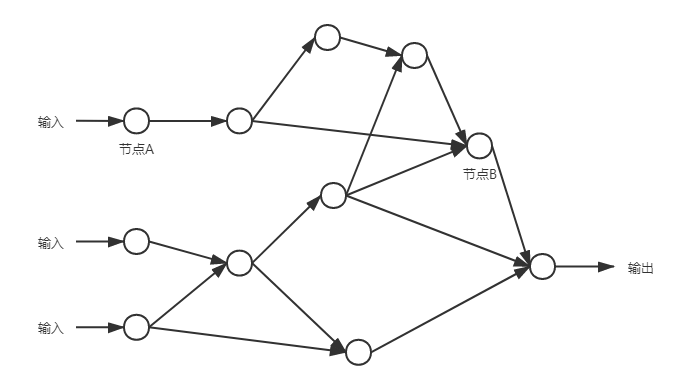
这就意味着我们可以复用机器的硬件资源,将节点A和节点B代表的任务在同一台机器上运行。
于是在节点调度过程中,我们可以抽象出一个硬件节点硬件资源池。在资源池中存在大量的硬件资源,当节点的计算任务要运行时,从资源池中取出节点硬件资源并载入计算任务,等计算任务结束后,将节点硬件资源归还到资源池中。如下所示。
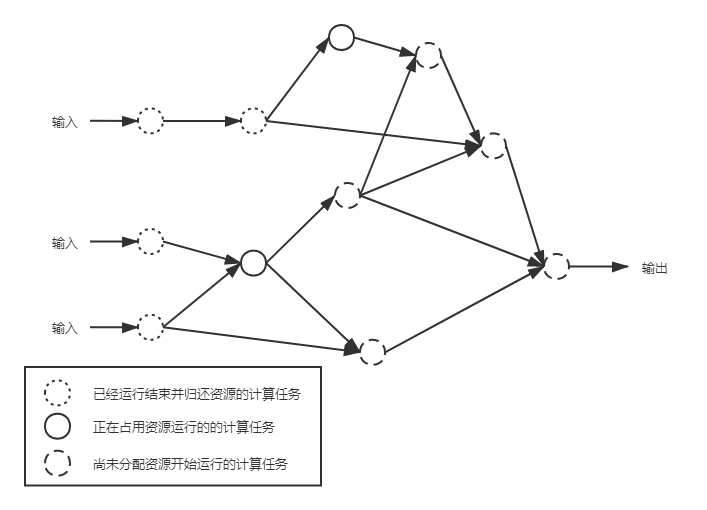
如此一来,大大提升了硬件资源的利用率。一个DAG可能包含众多节点,但在运行过程中占用的节点硬件资源的数目往往会小于DAG的节点数目。只用5个节点硬件资源跑完一张包含20个计算节点的DAG是很有可能的。
这一调度方式尤其适用于批处理系统,而可能不适用于流处理系统。因为在流处理系统中,输入是无界的,这往往要求所有节点都一直运行12。
4.2.3.2 节点触发调度
在DAG范式中,每个节点的运行情况要由前置节点的决定。每个节点要在前置节点运行成功后开始运行。
为了实现上述调度逻辑,我们可以设计两种机制:
- 第一种是全局监视机制。存在一个全局监视器,监测每个节点的运行情况,当发现某个节点符合运行条件时,将该节点唤醒。
- 第二种是独立触发机制。每一个节点在自己成功结束后都通知后续节点,同时每个节点在接收到前置节点的通知后都判断自身是否已经满足运行条件,并在满足条件时启动自身。
在使用独立触发机制时,可能需要提前为即将要执行的节点分配资源,以便于即将要执行的节点能够接收到前置节点发来的触发消息。但其实,无论采用哪种调度机制,从提升系统运行时间效率的角度看,提前为即将要执行的节点分配资源都是妥当的。
使用全局监视机制时,全局监视器可以负责硬件资源分配和计算任务启动两个工作。使用独立触发机制时,每个节点可以负责自身节点的计算任务启动外加后置节点的资源分配。
4.2.3.3 数据传输
在节点的资源调度部分我们已经说明,DAG中的两个节点可能并不会同时存在。这意味着,通过内存展开的节点间的数据直传可能没法开展。因此,每个节点的数据都需要落盘。
并且,一个节点可能会依赖许多前置节点的输出数据。因此,对每个节点的输出数据按照一定规范进行全局编号是必要的。
这样,当某个节点启动时,它需要根据输出数据的全局编号规范从硬盘中找到所需的数据,然后读入进行处理。并将处理结果按照全局编号规范命名后落盘。
落盘保证了中间数据的非易失,但是频繁的读写却会给整个系统带来性能瓶颈。我们可以尝试考虑节点间数据的内存直传方案。
如果要实现节点间数据的内存直传,则在传输时数据发送节点和数据接收节点都是存在的,这就意味着节点在运行结束后不能将资源回收,而是要等依赖该节点的所有后续节点都完成信息读入后才可以进行资源回收。如下图所示。
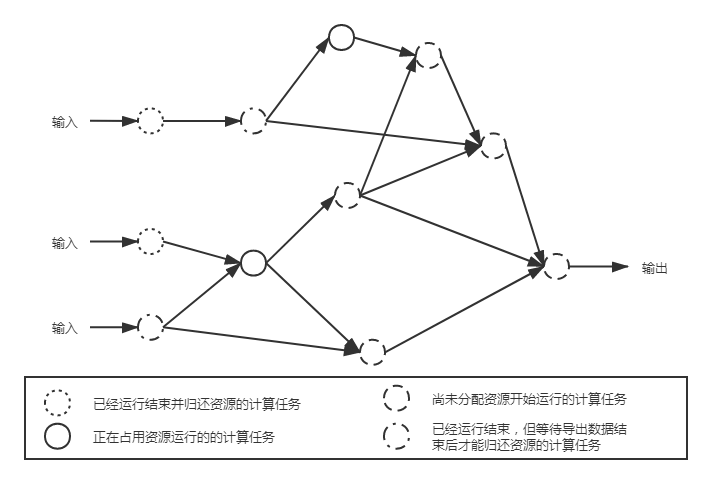
同样的,上述逻辑也有两种实现机制:
- 第一种是全局监视机制。存在一个全局监视器,监测每个节点的运行情况,当发现某个节点符合资源回收条件时,将该节点的资源回收。
- 第二种是独立触发机制。每一个节点在自己成功读入前面节点的数据后通知前面节点,同时每个节点在接收到后面节点的通知后都判断自身是否已经满足资源回收条件,并在满足条件时回收自身占用的硬件资源。
总体而言,中间数据落盘传输和内存直传各有优劣,大家可以结合自身系统的对运行速度的追求、中间数据量大小、中间数据量重要程度、节点资源的充足程度、系统开发复杂性等因素综合考量。
进一步地,我们可以考虑这样一种场景。在有向无环图中,节点A的输出作为节点B的输入,此时存在一次数据传递。而在实际进行节点调度时,系统可以在A任务执行完毕后,直接在相同的计算引擎上启动任务B。这样,节点A的输出结果直接留存在计算引擎存储中作为节点B的输入即可。于是,在有向无环图中存在的数据传递操作在实际实现中被省略了,这避免了序列化、网络传输、反序列化等过程带来的性能损耗,进而提升系统的运行效率。这是一种计算向存储靠拢的思想。甚至,再进一步,节点A和节点B的任务可以整合进同一个线程内串联执行。事实上,Flink的设计中就体现了这种思想(Flink中将这种操作称之为任务链接[13])。
4.3 典型框架Spark的使用
Spark是一个遵循DAG范式的并行框架,应用也较为广泛。
题外话:Spark和Flink的数据传输都是通过内存进行的,避免了频繁落盘,是它们效率远高于Hadoop的主要原因1012。其中,Spark对内存数据的抽象叫RDD,而且RDD是Spark系统的重要概念6。但本文侧重讨论并行计算,不去涉及这些内容,感兴趣的读者可以自行研究。
在了解了DAG范式的形式化表示、工程实现之后,我们再去学习Spark的使用也非常简单。同样,我们直接上手。
在DAG范式的形式化表示中我们已经说过,在使用框架时,需要我们确定的是每个节点的处理逻辑和节点组成的有向无环图。Spark便使用流式语句完成了上述两者的定义。
from pyspark import SparkContext

inputFile = "input.txt"
sc = SparkContext( appName="Yeecode Demo")
inputData = sc.textFile(inputFile)

inputData.map(lambda x:(x.split("\t")[0],x.split("\t")[3])) \
		.reduceByKey(lambda x,y:(float)(x)+(float)(y)) \
		.map(lambda x:x[0]+"\t"+x[1]) \
		.saveAsTextFile("/output/result.txt")
上述代码片段中,使用lambda函数进行了指定了每个节点的处理逻辑,例如lambda x:(x.split("\t")[0],x.split("\t")[3])表示取出记录的第0和第3列分别作为key和value。
流式语法则定义了一个下图所示的DAG。
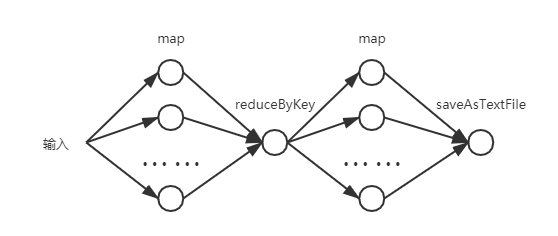
流式语法使用十分方便,可以快速地定义一个DAG。但是也有局限,难以定义同层级、间隔层级的数据流,也就是说下图虚线所示的数据流都难以被定义出来。因此不够灵活。
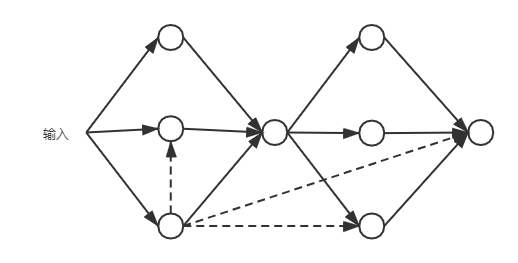
要想灵活地定义任意两个节点之间的数据流,可以使用定义点、边的方式。但直接使用文字定义点和边会很不直观,这时开发图形化界面就十分有必要。
4.4 DAG的实现总结
MapReduce那种先Map在Reduce的形式的并发效率并不高,尤其是当数据存在偏移时,常常出现整个系统等待最后一两个Map结束而无法启动Reduce的情况。MapReduce范式的固定的Map、Reduce的形式也限制了它的应用场景13。
DAG范式的出现极大地提升了并行计算系统的效率,也使得整个系统更为灵活。
灵活应用DAG范式可以解决众多业务场景下的问题。稍加演化,我们甚至可以支持节点的配置、支持节点处接受附加信息、支持任意节点重试等等。这些需求都可以依据业务场景演化DAG范式满足。
DAG对于用户而言也并不复杂,只需要定义节点和有向无环图即可。在设计DAG范式系统时,需要为用户提供定义节点和有向无环图的良好交互。
DAG范式系统的实现难点在于节点的规范化定义、图的处理、节点的资源调度等问题。这些需要结合业务场景解决。
5 总结与说点别的
计算的并行化是提升系统性能的重要手段,但除此之外,还有许多手段。本文作者写作的《高性能架构之道》一书,将从体系化的角度对软件系统的性能进行定义,并详细介绍分布式、并发编程、数据库调优、缓存设计、IO模型、前端优化、高可用等方面理论知识和工程实践,最后还依据上述知识完成了一个高性能系统的架构示例。以帮助大家从理论到实践了解高性能架构的全貌。
【TODO】
该书将在2021年元旦后与大家见面,感兴趣的读者可以关注。
并行计算可以进一步泛化,推广到网格计算14。这时,系统中的软硬件设施出现异构,不可靠性也会增加,甚至还会引入恶意节点。这时,需要更为复杂的调度手段、校验手段来保证系统的正常运行。其中的任何一个切入点都是一些很有意思的话题,但受限于篇幅,我们不再展开。
我们在生产中实现了一套十分通用的基于DAG范式的平台,它注重通用性而不侧重于大数据的并行计算。该系统具有以下特点:
- 用户可以基于图形化界面实现DAG的设计,包括节点的拖拽布局、有向边的连接,并且支持整个DAG的自动布局。
- 定义好的DAG支持多次的、从任意节点开始的重复执行。且每一次的执行结果都会被记录。
- 任意节点都支持配置、支持交互界面,任意节点都支持额外接收界面输入的数据。
- 设有全局事件通知机制,每个节点都可以接收到DAG中其他节点的事件通知,用以支持更为复杂的协作。
- 配有节点库,用户可以自行开发功能节点并添加到节点库中。因此,整个DAG会在业务人员的参与下成长为一个体系。
- 整个系统配有DAG模板库,用户可以直接从模板中选择DAG执行,便于规范化管理。
- 系统可接入自有的权限体系,可以灵活地对某些操作进行权限限制。
本文是在设计和实现上述系统的过程中从并行计算角度展开的一些讨论和思考,包括并行计算各种形式和演进过程的介绍和思考,也包括较为详细的MapReduce和DAG范式的介绍和思考。
最后,我是易哥,这里是架构研究所。希望本文能让大家有所收获,也欢迎大家共同参与讨论。
欢迎关注我们,我会偶尔出没分享软件架构和编程相关的干货知识。
本文部分参考文献:
-
Grama A, Kumar V, Gupta A, et al. Introduction to parallel computing[M]. Pearson Education, 2003. ↩︎
-
栾亚建, 黄翀民, 龚高晟, 等. Hadoop 平台的性能优化研究[J]. 计算机工程, 2010, 36(14): 262-263. ↩︎
-
Ekanayake J, Fox G. High performance parallel computing with clouds and cloud technologies[C]//International Conference on Cloud Computing. Springer, Berlin, Heidelberg, 2009: 20-38. ↩︎
-
Silva L M E, Buyya R. Parallel programming models and paradigms[M]//High Performance Cluster Computing Programming and Applications. Prentice Hall PTR, 1999: 4-27. ↩︎
-
Dean J, Ghemawat S. MapReduce: simplified data processing on large clusters[J]. Communications of the ACM, 2008, 51(1): 107-113. ↩︎ ↩︎
-
Armbrust M, Xin R S, Lian C, et al. Spark sql: Relational data processing in spark[C]//Proceedings of the 2015 ACM SIGMOD international conference on management of data. 2015: 1383-1394. ↩︎ ↩︎ ↩︎
-
MapReduce-维基百科,自由的百科全书,https://zh.wikipedia.org/wiki/MapReduce ↩︎
-
陈明. MapReduce 分布编程模型[J]. 计算机教育, 2014, 1: 104-107. ↩︎
-
Zaharia M, Konwinski A, Joseph A D, et al. Improving MapReduce performance in heterogeneous environments[C]//Osdi. 2008, 8(4): 7. ↩︎
-
王强, 李俊杰, 陈小军, et al. 大数据分析平台建设与应用综述[J]. 集成技术, 2016, 5(02):2-18. ↩︎ ↩︎
-
Isard M, Budiu M, Yu Y, et al. Dryad: distributed data-parallel programs from sequential building blocks[C]//Proceedings of the 2nd ACM SIGOPS/EuroSys European Conference on Computer Systems 2007. 2007: 59-72. ↩︎
-
alavri V, Hueske F. 基于Apache Flink的流处理[J]. 中国电力出版社, 2020. ↩︎ ↩︎
-
冯兴杰, 王文超. Hadoop与Spark应用场景研究[J]. 计算机应用研究, 2018, 35(09):2561-2566. ↩︎
-
徐志伟, 冯百明, 李伟. 网格计算技术[M]. 电子工业出版社, 2004. ↩︎
可以访问个人知乎阅读更多文章:易哥(https://www.zhihu.com/people/yeecode),欢迎关注。
作者书籍推荐

